
对比主流向量库选型(知识库存储)

Milvus / Qdrant / Chroma / Pinecone 向量库选型对比
一句话定位
- Chroma:原型Demo、本地开发,不适合生产高并发
- Qdrant:Rust高性能,中小‑亿级生产首选,元数据过滤极强,部署简单
- Milvus:CNCF开源分布式,十亿/百亿级大规模、多模态、私有化企业级,运维较重
- Pinecone:全托管SaaS,零运维,不能私有化,海外优先,成本高
完整对比表
| 对比维度 | Chroma | Qdrant | Milvus | Pinecone |
|---|---|---|---|---|
| 开源 | ✅ Apache2.0 | ✅ Apache2.0 | ✅ Apache2.0 | ❌ 闭源SaaS |
| 开发语言 | Python | Rust | C++/Go | 闭源 |
| 部署方式 | 进程内嵌入 / 简易服务 | 单二进制 / Docker / K8s;托管云 | K8s集群,依赖etcd+MinIO;Zilliz托管 | 仅云托管,无法本地私有化 |
| 推荐向量规模 | <100万(原型) | 10万~数亿 | 千万~百亿级 | 百万~亿级 |
| 元数据过滤 | 基础过滤,性能一般 | 极强,复杂条件、嵌套过滤性能优秀 | 强 | 支持过滤,能力中等 |
| 索引支持 | HNSW | HNSW、Disk‑HNSW、量化 | HNSW、IVF‑FLAT、DiskANN,GPU加速 | 内置,用户不可调细节 |
| 持久化 | 本地文件持久化 | WAL、快照、磁盘索引 | 对象存储MinIO | 云托管自动持久化 |
| 多租户 | 弱 | Collection/Namespace | 完整多租户、RBAC | Namespace |
| 中文生态 | 一般 | 英文社区为主 | 中文文档、国内社区最强 | 国内访问不稳定 |
| 运维成本 | 极低 | 低,单容器即可跑 | 高,集群组件多 | 0(全托管) |
| 典型优点 | 上手最快,LangChain/LlamaIndex原生集成,几行代码跑通RAG | Rust低延迟,磁盘索引,过滤性能强,资源占用低,部署简单 | 分布式水平扩展,索引种类最全,支持GPU,多模态检索,企业级能力完善 | 开箱即用,自动扩缩容,不用管底层运维 |
| 典型缺点 | 高并发、大数据性能差;不适合生产流量 | 十亿以上大规模集群案例少于Milvus | 组件多,部署复杂,版本迭代快 | 成本高,数据必须上对方云,国内网络问题,无法私有化部署 |
| 适合场景 | 本地实验、POC原型、Demo、个人学习 | 企业RAG知识库、权限过滤场景、中小规模生产、私有化部署、边缘场景 | 海量向量、图片音视频多模态检索、大型企业私有化项目、高并发生产 | 创业团队无运维,海外业务,快速上线MVP |
通俗选型口诀
-
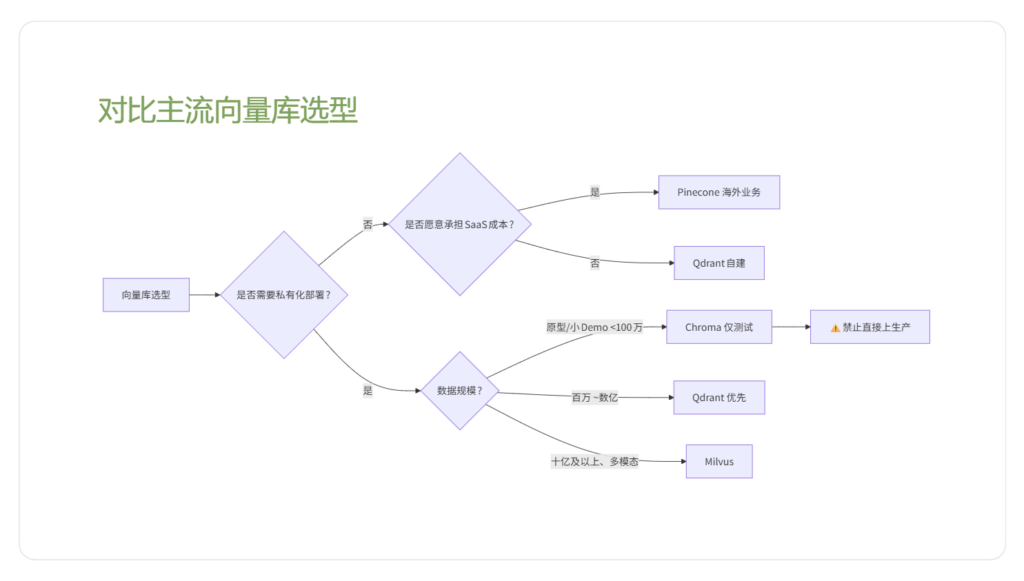
做Demo、本地跑RAG验证链路 → Chroma
只用来调试chunk、embedding召回逻辑,不要直接上生产环境。
-
自建生产环境,百万~数亿向量,大量元数据过滤(权限、标签、时间) → Qdrant
当前综合性价比最高,单Docker即可启动,不用一堆依赖组件,Rust性能强,国内很多中小AI项目首选。
-
十亿+向量、多模态图像视频检索、大型企业私有化、需要GPU加速 → Milvus
有运维团队、K8s环境;不想运维就买Zilliz Cloud托管版。
-
不想管运维、海外业务,能接受数据上公有云、预算充足 → Pinecone
国内不推荐,网络访问不稳定,不能私有化,数据合规风险大。
补充:pgvector(PostgreSQL插件)什么时候选
- 已有PostgreSQL业务,向量规模百万以内,不想额外维护一套向量服务;
- 优点:一套库同时做业务SQL+向量检索;缺点:千万级以上向量检索性能远低于专用向量库。
Mermaid快速选型流程图
踩坑提醒
- Chroma千万不要直接上线上高并发生产,它定位是原型工具;
- Milvus自建不要单机跑生产,生产建议K8s,需要维护etcd、MinIO;
- Pinecone国内访问延迟高,合规场景直接排除;
- Qdrant的分布式能力不如Milvus,但绝大多数中小业务单机足够;
- 生产上线前务必做POC:拿真实业务向量、真实查询QPS做压测。

没有回复内容